UT01 - Introducción a las Bases de Datos
Conexión legislativa
En esta Unidad de Trabajo nos centraremos en:
Introducción
Hay una frase muy icónica sobre la importancia de los datos que fue acuñada por Clive Humby: "los datos son el nuevo petróleo". A pesar de que el petróleo sigue siendo de gran importancia para la sociedad moderna, los datos, cada vez más, están ganando esa carrera. Sin embargo, como el petróleo, los datos deben ser refinados para que realmente tengan un valor. Cuando esto ocurre, dejamos de hablar de datos y empezamos a hablar de información.
¿Qué diferencia hay entre los datos y la información?
Algo indispensable para la información es que esté adecuadamente contextualizada:
- Dato:
1000€, un hecho en bruto, sin significado. - Información: "1 semana de alquiler en Mallorca en el mes de julio son 1000€", hecho contextualizado.
El dato adquiere más sentido cuando se le añade contexto. El verdadero impacto se produce cuando la información se convierte en conocimiento. Si la información nos dice qué está ocurriendo, el conocimiento nos explica por qué sucede y cómo debemos actuar:
- Información: "1 semana de alquiler en Mallorca son 1000€".
- Conocimiento: "El promedio de alquileres en Mallorca durante la temporada alta son 1500€, y julio forma parte de la temporada alta, por lo que 1000€ es una gran oportunidad de inversión" es una información analizada y lista para tomar decisiones.
Estos 3 conceptos: dato, información y conocimiento forman parte de lo que se conoce como "la pirámide DIKW": Data, Information, Knowledge, Wisdom.
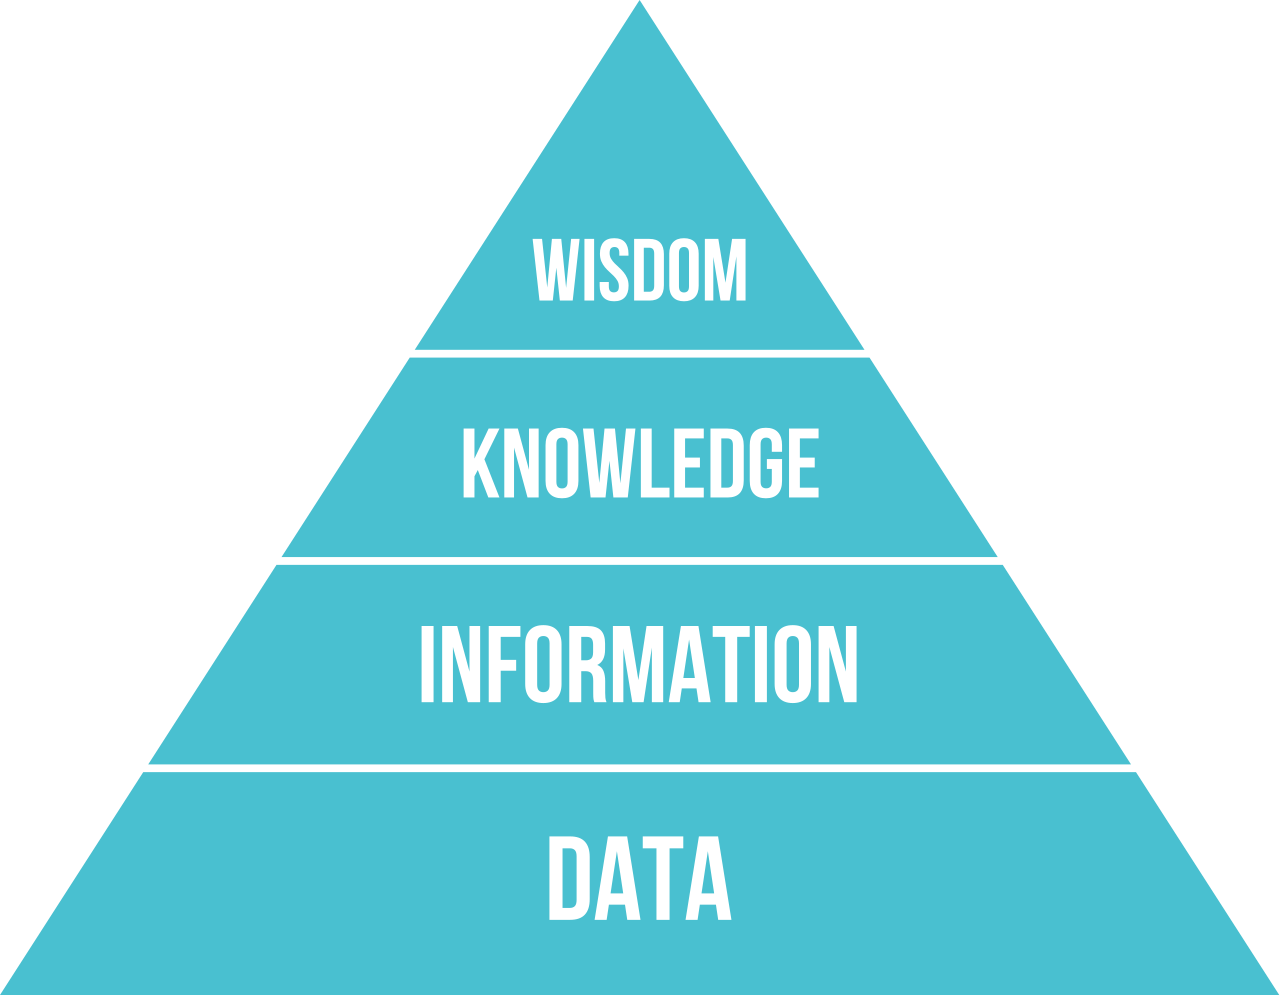
Fuente: Wikipedia
¿Y qué hay de la sabiduría? Es la que nos ayuda a responder a la pregunta de "¿Qué es lo mejor a largo plazo?". Incorpora una visión más global de todo el conocimiento disponible, así como ética y valores o aspectos de sostenibilidad.
- Conocimiento: "El promedio de alquileres en Mallorca durante la temporada alta son 1500€, y julio forma parte de la temporada alta, por lo que 1000€ es una gran oportunidad de inversión".
- Sabiduría: "Pese a ser una oportunidad rentable, el mercado vacacional en esa zona enfrenta rechazo social y futuras restricciones normativas, por lo que es más aconsejable invertir en activos menos volátiles". Hay una evaluación del riesgo, un contexto ético y una visión a largo plazo.
Para poder construir esta pirámide es fundamental contar con sistemas capaces de almacenar, organizar, recuperar y transformar grandes volúmenes de datos. En este módulo aprenderemos a diseñar y crear estos sistemas, así como a introducir, recuperar y transformar datos en bruto para obtener información útil. Pero primero es necesario revisar cómo se gestionaban los datos en los comienzos de la informática.
Ficheros
En un principio, la manera de gestionar los datos en la informática era mediante ficheros. Cada programa o aplicación guardaba su propia información en archivos independientes, como .txt, .csv o .dat, emulando de forma digital el antiguo sistema de carpetas y archivadores de oficina. Aunque esta aproximación supuso un gran paso respecto al papel, pronto aparecieron inconvenientes que dificultaban el tratamiento de los datos.
Los ficheros, generalmente, se dividen en 2 tipos:
- Ficheros de texto plano: contienen texto, perfectamente legibles por seres humanos, aunque no necesariamente pensados para su lectura por humanos.
- Ficheros binarios: contienen cadenas de bytes que representan datos estructurados o ejecutables, diseñados para ser procesados directamente por una máquina y no legibles por los seres humanos.
Además, los ficheros tienen una extensión que representa su formato y le indica al sistema operativo qué software debe utilizarse para procesarlos correctamente. Por ejemplo:
- Ficheros de texto plano: algunos formatos típicos son
.txt,.csv,.xml,.json,.yamlo.ini... - Ficheros binarios: tenemos
.jpeg,.mp3,.exe,.pdf,.dat...
txt: text, para texto genérico, sin formato concreto
csv: comma separated values, valores separados por comas
xml: extensible markup language, utiliza etiquetas para estructurar datos jerárquicamente
json: javascript object notation, formato ligero basado en pares clave-valor
yaml: yaml ain't markup language, enfocado en la legibilidad humana mediante sangrías
ini: initialization, ficheros de configuración sencillos
jpeg: joint photographic experts group, para imágenes
mp3: mpeg-1 audio layer iii, para sonido
exe: executable, para programas en Windows
pdf: portable document format, para representación de documentos
dat: data, fichero de datos genérico cuyo formato binario específico sólo conoce la aplicación que lo creó
Ficheros para el almacenamiento de datos de programas
Cuando un fichero se utiliza para almacenar datos de programas, se dice que está compuesto por registros (filas dentro del fichero). Cada uno de estos registros se divide en campos, que representan una unidad elemental de información de dicho registro.
Crea un fichero llamado "clientes.csv" y añade la siguiente información:
nombre,apellidos,dni,dirección
Juan,Pérez Gómez,50013619G,Calle Mayor 12
María,López Torres,88619580M,Avenida de la Constitución 42
Rosa,Sánchez Ruíz,21134217T,Plaza España 8
- La primera línea del fichero contiene los campos:
nombre,apellidos,dni,dirección - A partir de la segunda línea empiezan los registros
3, porque la primera fila sólo define la estructura, no contiene datos, sino metadatos
Crea otro fichero llamado "ventas.csv" y añade la siguiente información:
dni_cliente,producto,cantidad,dirección_envío
50013619G,Ratón Inalámbrico,1,Calle Mayor 12
Redundancia, repetición de datos
Aunque estos ficheros son fáciles de entender y editar, el almacenamiento de datos en ficheros presenta varios problemas:
- Redundancia e inconsistencia: hay datos repetidos entre ficheros, como la dirección. Más datos almacenados = ficheros más grandes. Además, si modificamos la dirección en alguno de los ficheros, deberemos asegurarnos de actualizarla en todos los demás, o bien guardaremos datos contradictorios sobre la misma persona.
- Acoplamiento: si mañana queremos añadir un campo adicional, como
teléfono, el formato del fichero cambiará y, si hemos diseñado un programa que lee 4 campos, fallará al procesar el fichero con 5 campos. - Falta de concurrencia: si 2 personas intentan escribir en alguno de los ficheros al mismo tiempo, este corre el riesgo de corromperse o perder información.
- Falta de seguridad: no es posible establecer restricciones de seguridad para campos concretos. Si un empleado necesita ver sólo las direcciones de los clientes, tendrá acceso a todos los demás campos.
Es por ello que, a día de hoy, se opta por lo que se conoce como Bases de Datos.
Bases de datos
Una Base de Datos (BD) es una colección organizada de datos relacionados entre sí, estructurados de forma lógica y almacenados sistemáticamente en soportes digitales para su posterior consulta, actualización y gestión. En última instancia, los datos se almacenan directamente en ficheros físicos en el disco duro pero, para su acceso, nunca se trabajan con ficheros, sino con lenguajes y aplicaciones especializadas.
Tipos de Bases de Datos
Dependiendo del criterio que utilicemos para clasificar las Bases de Datos, se pueden clasificar principalmente en:
- Según la localización de los datos: centralizadas, distribuidas.
- Según la variabilidad de los datos: estáticas, dinámicas.
- Según el modelo de datos: relacionales, no relacionales, orientadas a objetos.
Según la localización de los datos
Tradicionalmente, las bases de datos han seguido un modelo centralizado y basado en un modelo conocido como cliente-servidor. Esto es: existe un servidor que aloja la base de datos, y esta reside en una sola máquina. Las diferentes aplicaciones que necesitan conectarse a la base de datos (clientes) lo hacen mediante una conexión remota.
Con el crecimiento del volumen de datos y la necesidad de alta disponibilidad, el modelo centralizado presenta limitaciones (puntos únicos de fallo, problemas de latencia e incapacidad de escalar indefinidamente en una sola máquina). Para resolver esto surgen las bases de datos distribuidas, donde los datos no residen en un solo equipo, sino que están repartidos lógicamente en varios nodos o servidores interconectados a través de una red.
Políticas de fragmentación de la información
Para distribuir la información entre diferentes servidores, la base de datos aplica diferentes estrategias conocidas como fragmentación:
- Fragmentación horizontal: se dividen los datos a nivel de registro.
- Fragmentación vertical: se dividen los datos a nivel de campo.
- Fragmentación mixta (o híbrida): combina la horizontal y la vertical.
Supón que tenemos una base de datos distribuida en 2 servidores: S1 y S2. Siguiendo el ejemplo de los clientes.csv del apartado de ficheros, responde a las siguientes preguntas:
nombre y apellidos se guarden en S1 y los de dni y dirección en S2, ¿qué política de fragmentación estamos aplicando?Vertical, porque estamos fragmentando los datos a nivel de campo
Horizontal, porque estamos fragmentando los datos a nivel de registro
dirección de los clientes cuyo nombre empiece por las letras A-L se guarden en S1 y el resto de datos se guarden en S2, ¿qué política de fragmentación estamos aplicando?Mixta, porque estamos fragmentando los datos a nivel de registro y a nivel de campo
Según la variabilidad de los datos
Atendiendo al uso principal que se le da a la información y a la frecuencia con la que esta se modifica o consulta, distinguimos dos grandes tipos:
- Bases de Datos Dinámicas: diseñadas para la gestión de datos en tiempo real. La información se modifica, añade, actualiza o elimina constantemente. También se las conoce como sistemas OLTP (Online Transaction Processing o Procesamiento de Transacciones en Línea).
- Bases de Datos Estáticas: diseñadas principalmente para la lectura y el análisis de información histórica. No están pensadas para modificar registros en el día a día, sino para acumular grandes volúmenes de datos a lo largo del tiempo. También se las conoce como sistemas OLAP (Online Analytical Processing o Procesamiento Analítico en Línea).
En el trabajo diario de una empresa, las bases de datos dinámicas (OLTP) registran cada interacción inmediata (ventas, altas, facturas). Periódicamente, mediante procesos de extracción y transformación (ETL), esos datos se vuelcan en una base de datos estática (OLAP) donde los analistas de negocio (Business Intelligence) realizan informes sin ralentizar la base de datos operacional
Según el modelo de datos
El modelo de datos es el conjunto de herramientas conceptuales para describir los datos, sus relaciones, su significado y sus restricciones, de manera que se facilita la interpretación del mundo real y su representación en forma de datos en un sistema informático.
La evolución de los modelos de datos con el tiempo es el resultado de la evolución técnica de los sistemas de tratamiento de datos. En líneas generales podemos distinguir los siguientes:
-
Modelo jerárquico: los datos se estructuran en forma de árbol. Los registros se almacenan en nodos con 1 padre y muchos hijos, como si fuera un árbol genealógico. A este tipo de relación se la conoce como uno a muchos.
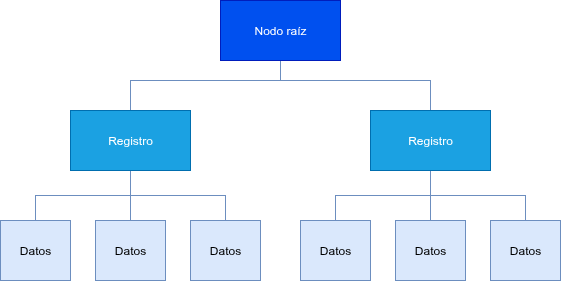
Elaboración propia -
Modelo en red: en lugar de almacenar las relaciones en forma de árbol, se hace en forma de red o grafo, de manera que un nodo hijo puede tener varios padres y viceversa. Aparecen las relaciones muchos a muchos.
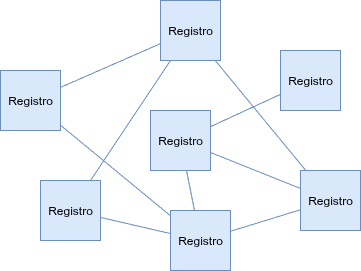
Elaboración propia -
Modelo relacional: basado en las relaciones entre estructuras bidimensionales en forma de tabla que almacenan datos de manera parecida al ejemplo de que vimos en ficheros. Es el modelo más utilizado y el que más trabajaremos en este módulo.
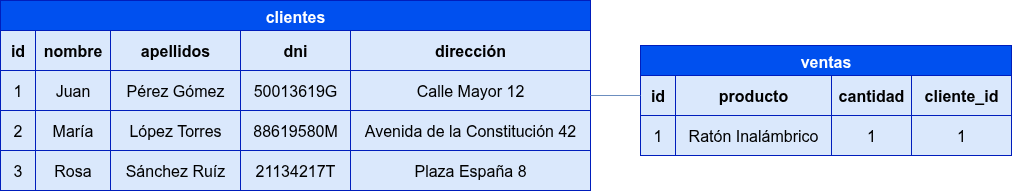
Elaboración propia -
Modelo orientado a objetos: basado en la filosofía de la Programación Orientada a Objetos (POO). Permiten la definición de tipos de datos complejos. Si bien las bases de datos orientadas a objetos puras están en desuso, sí existen alternativas objeto-relacionales con gran implantación en el mercado. Estas combinan el modelo relacional y el modelo orientado a objetos.
-
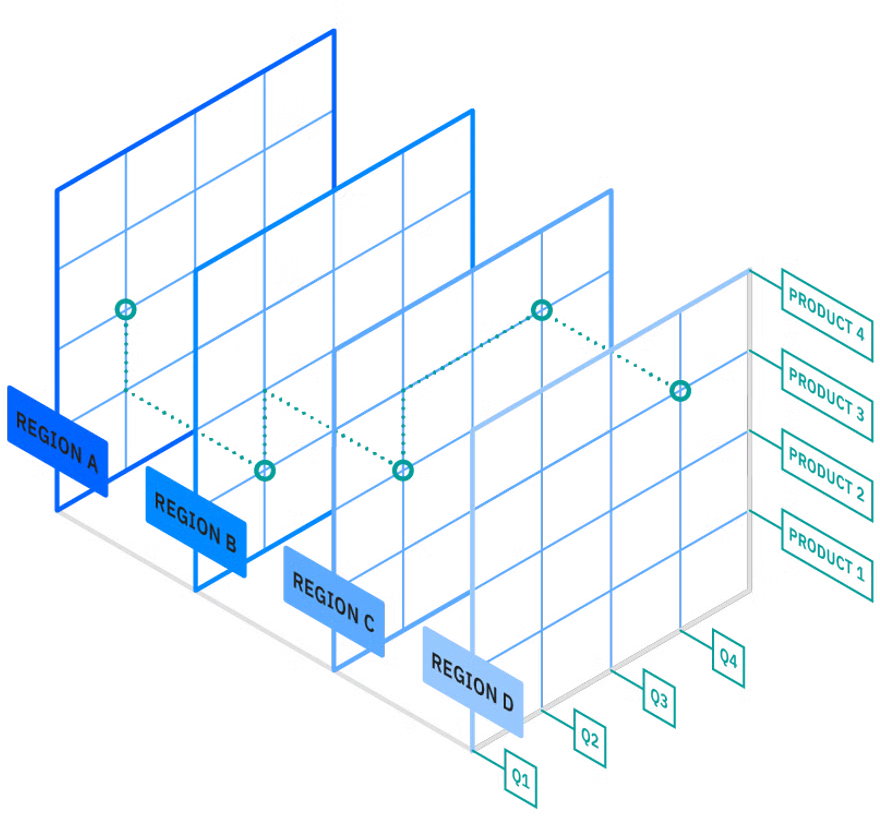
Modelo multidimensional: cuando el volumen de datos y las relaciones entre ellos es excesivamente grande, se organizan en hipercubos de n-dimensiones. Son fundamentales en los sistemas OLAP.
Fuente: IBM -
Modelo orientado a documentos: los datos están semi-estructurados. Los registros y todos sus datos se almacenan en documentos, normalmente en formato JSON. La mayor ventaja es que el esquema (la estructura) de los datos puede variar según convenga. También trabajaremos con este tipo de bases de datos más adelante.
{
    "id": 1,
    "nombre": "Juan",
    "apellidos": "Pérez Gómez",
    "dni": "50013619G",
    "dirección": "Calle Mayor 12"
}
Operaciones fundamentales: CRUD
Casi cualquier interacción con una base de datos se reduce a cuatro operaciones básicas:
- Create (crear): añadir nuevos datos.
- Read (consultar): recuperar datos existentes.
- Update (actualizar): modificar información almacenada.
- Delete (eliminar): borrar datos obsoletos.
Para ver cómo se aplican estas operaciones en otros contextos (como peticiones HTTP en la web o manipulación de ficheros en programación), consulta la nota principal: CRUD.
Para que todas estas operaciones se ejecuten de forma transparente, sin que el usuario ni el programador tengan que manipular los archivos físicos en el disco, necesitamos un software especializado: el Sistema de Gestión de Bases de Datos (SGBD) o DBMS (Database Management System).
Sistema Gestor de Bases de Datos
Los Sistemas Gestores de Bases de Datos (SGBD), también conocidos como DataBase Management Systems (DBMS) son herramientas que permiten crear, organizar, manipular y administrar las bases de datos.
Actualmente existen muchos SGBD, cuyo funcionamiento está principalmente determinado por el modelo de datos utilizado. Algunos ejemplos de ellos son:
- En bases de datos relacionales: MariaDB, MySQL, SQLite
- En bases de datos objeto-relacionales: PostgreSQL
- En bases de datos documentales: MongoDB
MariaDB es un fork de MySQL creado por el propio fundador de MySQL tras la compra de Sun Microsystems por parte de Oracle. Su objetivo fue garantizar una alternativa 100% libre y gratuita, compatible a nivel de comandos y sintaxis con MySQL.
Funciones de un SGBD
Las funciones de un SGBD son:
- Integridad de los datos: los datos almacenados son correctos, completos, consistentes y precisos a lo largo del tiempo, cumpliendo reglas de validación predefinidas.
- Redundancia mínima o controlada: se evita duplicar datos innecesariamente.
- Independencia de los datos: separación entre la estructura lógica de los datos, su almacenamiento físico y las aplicaciones que los utilizan.
- Seguridad: control de acceso mediante usuarios, roles y privilegios.
- Metadatos: proporcionan un diccionario de metadatos, que contiene el esquema de la base de datos. Es decir, cómo están estructurados los datos en tablas, registros y campos, las relaciones entre los datos, usuarios, permisos, etc.
- Sistema de transacciones: garantizan la atomicidad, consistencia, aislamiento y durabilidad de las operaciones que se realizan, permitiendo deshacer cambios en caso de incidencia.
ACID
Las propiedades ACID aseguran la transaccionalidad de los datos:
- Atomicidad: o se realizan todas las operaciones implicadas o no se realiza ninguna.
- Consistencia: los datos pasan de un estado válido a otro.
- Isolation (Aislamiento): una transacción no afecta a otras, por lo que las modificaciones sobre un registro durante la ejecución de una transacción no son visibles para otras transacciones hasta que no termine la primera.
- Durabilidad: la escritura de los datos asegura que, una vez finalizada una operación, los datos no se perderán.
Inconvenientes de los SGBD
Aunque los SGBD solucionan los problemas de los ficheros tradicionales, implican una serie de costes y compromisos que hacen que no siempre sean la solución óptima para cualquier escenario:
- Coste económico
- Complejidad de instalación y administración
- Consumo de recursos
- Sobrecarga para tareas sencillas
Componentes de un SGBD
Para llevar a cabo todas sus funciones, un SGBD se compone de un conjunto de módulos que interactúan entre sí:
- Diccionario de datos: repositorio que almacena los metadatos (esquemas, tablas, campos, tipos de datos, restricciones, relaciones y permisos de usuarios).
- Espacio de datos: zona donde se almacenan los datos en sí.
- Procesador de consultas (Query Processor): recibe las peticiones escritas por los usuarios o aplicaciones, las analiza sintácticamente, las optimiza y genera un plan de ejecución eficiente.
- Gestor de transacciones y concurrencia: coordina los accesos simultáneos a los datos garantizando las propiedades ACID, aplicando bloqueos cuando es necesario y evitando conflictos entre usuarios.
- Herramientas de administración: gestionadas exclusivamente por el DBA (DataBase Administrator). Estas permiten especificar:
- Mecanismos de recuperación ante posibles caídas del sistema (failover).
- Configuración de copias de seguridad (backups).
- Configuración de la fragmentación de los datos (en el caso de bases de datos distribuidas).
- Gestión de usuarios y permisos.
- Herramientas de programación: utilizadas por programadores y DBA para interactuar con el SGBD a través de lenguajes de consulta.
Lenguajes de un SGBD
Para interactuar con la base de datos, el SGBD proporciona un lenguaje de consulta. En las bases de datos relacionales, el estándar es SQL (Structured Query Language). Este lenguaje se divide funcionalmente en 4 subcategorías:
- DDL (Data Definition Language - Lenguaje de Definición de Datos): permite definir y modificar la estructura de la base de datos. Sus cláusulas son del tipo
CREATE(crear tablas),ALTER(modificar tablas) oDROP(eliminar tablas). - DML (Data Manipulation Language - Lenguaje de Manipulación de Datos): permite realizar las operaciones de CRUD sobre los datos. Permite seleccionar datos con
SELECT, insertarlos conINSERT, actualizarlos conUPDATEo eliminarlos conDELETE. - DCL (Data Control Language - Lenguaje de Control de Datos): gestiona los permisos y la seguridad. Ejemplos:
GRANT,REVOKE. - TCL (Transaction Control Language - Lenguaje de Control de Transacciones): administra las transacciones para garantizar las propiedades ACID. Ejemplos:
COMMIT,ROLLBACK. Aunque puede configurarse el SGBD para que se encargue de esto automáticamente, en ocasiones querremos tener un control manual.
Arquitectura de 3 Niveles
Para garantizar la independencia de datos (que los cambios en el soporte físico no afecten a las aplicaciones del usuario), el grupo ANSI/SPARC (American National Standards Institute, Standards Planning And Requirements Comitee) definió, en los años 70, una arquitectura de 3 niveles de abstracción claramente diferenciados:
- Nivel Externo (o de Vistas): es la visión de la base de datos que tienen los usuarios finales o aplicaciones. Cada usuario ve únicamente la información relevante para su trabajo a través de vistas personalizadas, ocultando el resto de la base de datos por motivos de simplicidad y seguridad. También permite generar informes y formularios para la consulta e introducción de datos a usuarios sin conocimientos técnicos sobre el lenguaje de consulta.
- Nivel Conceptual: es la visión global e integrada de toda la base de datos. Describe qué datos se almacenan, qué relaciones existen entre ellos y qué restricciones de integridad se aplican, de forma totalmente independiente del hardware y del software del SGBD.
- Nivel Interno (o Físico): describe cómo se almacenan físicamente los datos en los soportes de almacenamiento (estructuras de archivos, índices de búsqueda, punteros, bloques de disco y técnicas de compresión).
- Independencia lógica: permite modificar el nivel conceptual (añadir una nueva tabla o campo) sin tener que rehacer las aplicaciones del nivel externo.
- Independencia física: permite cambiar el almacenamiento físico (migrar de un disco SSD a un array RAID o modificar los índices) sin alterar el nivel conceptual ni el código de las aplicaciones.
graph TD
    classDef externo fill:#3b82f6,stroke:#1d4ed8,color:#fff;
    classDef conceptual fill:#10b981,stroke:#047857,color:#fff;
    classDef interno fill:#f59e0b,stroke:#b45309,color:#fff;
    classDef fisico fill:#6b7280,stroke:#374151,color:#fff;

    subgraph Nivel_Externo ["1. NIVEL EXTERNO (vistas)"]
        V1["Vista usuario / App 1"]
        V2["Vista usuario / App 2"]
        V3["Vista usuario / App N"]
    end

    subgraph Nivel_Conceptual ["2. NIVEL CONCEPTUAL (esquema lógico)"]
        NC["Esquema conceptual
(entidades, relaciones y reglas)"]
    end

    subgraph Nivel_Interno ["3. NIVEL INTERNO (esquema físico)"]
        NI["Esquema interno
(estructuras de almacenamiento e índices)"]
    end

    subgraph Almacenamiento ["ALMACENAMIENTO FÍSICO"]
        BD[("Base de Datos en disco")]
    end

    V1 <-->|"Independencia lógica"| NC
    V2 <-->|"Independencia lógica"| NC
    V3 <-->|"Independencia lógica"| NC

    NC <-->|"Independencia física"| NI
    NI <--> BD

    class V1,V2,V3 externo;
    class NC conceptual;
    class NI interno;
    class BD fisico;
Pueden existir uno o más niveles externos, pero solamente existe un nivel conceptual y un nivel interno.
En el ciclo de DAW, el objetivo principal no es formar administradores de bases de datos (DBA), sino desarrolladores web. Por ello, tus metas principales serán:
- Diseñar esquemas correctos (Nivel Conceptual: modelo Entidad-Relación y paso a tablas).
- Explotar y consultar la base de datos de forma eficiente mediante código (Nivel Externo).
Por tanto, en este módulo no nos preocuparemos tanto por la parte física de la base de datos, nos centraremos mucho más en la parte lógica.
Si ahora mismo este nivel de abstracción resulta algo complejo de visualizar, no te preocupes. A medida que diseñemos nuestras primeras tablas y ejecutemos consultas en las siguientes unidades, todo irá cobrando sentido de forma natural.
Legislación sobre el uso de Bases de Datos en España
En España, el tratamiento y almacenamiento de datos de carácter personal en bases de datos está estrictamente regulado para proteger la privacidad y los derechos de los ciudadanos.
Como desarrolladores web, no basta con que una base de datos sea eficiente y segura a nivel técnico, también debe cumplir la legalidad vigente
Marcos Normativos Principales
Actualmente, el marco legal se compone principalmente de dos normativas interconectadas:
- RGPD (Reglamento General de Protección de Datos):
- Ámbito: Unión Europea (Reglamento UE 2016/679).
- Impacto: es la norma suprema en materia de protección de datos en todos los países de la UE. Introduce sanciones elevadas y el principio de responsabilidad proactiva. Esto es: las empresas que manejen datos personales con alguna aplicación informática no sólo deben cumplir la ley, sino que tienen que ser capaces de demostrar que adoptan las medidas técnicas necesarias para garantizar la seguridad de los datos desde la fase de diseño de dicha aplicación.
- LOPDGDD (Ley Orgánica de Protección de Datos y Garantía de los Derechos Digitales):
- Ámbito: España (Ley Orgánica 3/2018).
- Impacto: adapta y especifica el RGPD europeo a la legislación española, incluyendo además un capítulo dedicado a los derechos digitales (derecho al olvido, desconexión digital, neutralidad de la red, etc.). Además, establece una autoridad de control: la Agencia Española de Protección de Datos (AEPD)
Curiosidad
La AEPD es el organismo oficial encargado de velar por la privacidad y aplicar las sanciones por incumplimiento. En su guía sobre el uso de dispositivos móviles en centros docentes, alertan de los riesgos para la privacidad del alumnado y desaconsejan el uso de teléfonos móviles personales en las aulas cuando existan otros medios educativos más idóneos.
El artículo 9 del RGPD define lo que se consideran datos de categoría especial (o datos sensibles). Se prohíbe con carácter general el tratamiento de este tipo de información, salvo excepciones muy concretas y reguladas. Estos datos incluyen:
- Origen étnico o racial.
- Opiniones políticas, convicciones religiosas o filosóficas.
- Afiliación sindical.
- Datos genéticos y datos biométricos orientados a identificar a una persona de manera unívoca (como huellas dactilares o reconocimiento facial).
- Datos relativos a la salud.
- Datos relativos a la vida o la orientación sexual.
Requisitos y obligaciones - Derechos ARSULIPO
Como desarrolladores, vamos a tener acceso a datos personales de los usuarios que utilicen nuestras aplicaciones y debemos cumplir de forma estricta los principios y obligaciones legales indicados por el RGPD (licitud, minimización, exactitud, limitación del plazo, seguridad, etc.).
Para garantizar el cumplimiento de estos principios, la legislación reconoce a los ciudadanos los llamados derechos ARSULIPO. Nuestra responsabilidad como desarrolladores web es diseñar la base de datos y la lógica de la aplicación web para responder técnicamente a cada uno de ellos:
- A - Acceso: el usuario tiene derecho a saber qué datos personales suyos tenemos almacenados.
- Por ejemplo: debemos diseñar una vista en la aplicación ("Mi Perfil") que consulte y muestre todos los registros asociados al usuario en la base de datos.
- R - Rectificación: el usuario puede exigir la corrección de datos inexactos o incompletos.
- Por ejemplo: habilitar formularios web de edición que ejecuten operaciones de actualización (
UPDATE).
- Por ejemplo: habilitar formularios web de edición que ejecuten operaciones de actualización (
- SU - Supresión ("Derecho al olvido"): el usuario tiene derecho a solicitar el borrado de sus datos cuando finalice la relación o retire su consentimiento.
- Por ejemplo: ejecutar un borrado físico (
DELETE) o anonimizar la información (como renombrar el registro aUsuario_Eliminado). Si existe una obligación legal de conservar ciertos datos, se debe aplicar un bloqueo de datos previo a su destrucción definitiva.
- Por ejemplo: ejecutar un borrado físico (
- LI - Limitación del tratamiento: el usuario puede solicitar que se suspenda temporalmente el uso de sus datos.
- Por ejemplo: incluir un campo los datos de usuarios (como
is_restricted = true) para omitir la fila en las consultas habituales.
- Por ejemplo: incluir un campo los datos de usuarios (como
- P - Portabilidad: el usuario tiene derecho a obtener una copia de sus datos para trasvasarlos libremente a otra plataforma.
- Por ejemplo: crear una opción que extraiga la información del usuario y genere un archivo descargable en un formato estructurado y estándar (XML, JSON, CSV...).
- O - Oposición: el usuario puede negarse a que sus datos se utilicen para fines secundarios para los que no dio un consentimiento explícito (como el envío de publicidad o la elaboración de perfiles para campañas de marketing).
- Por ejemplo: se deben incluir casillas de verificación en el panel de configuración del usuario para que pueda desactivar los envíos comerciales sin necesidad de eliminar su cuenta.
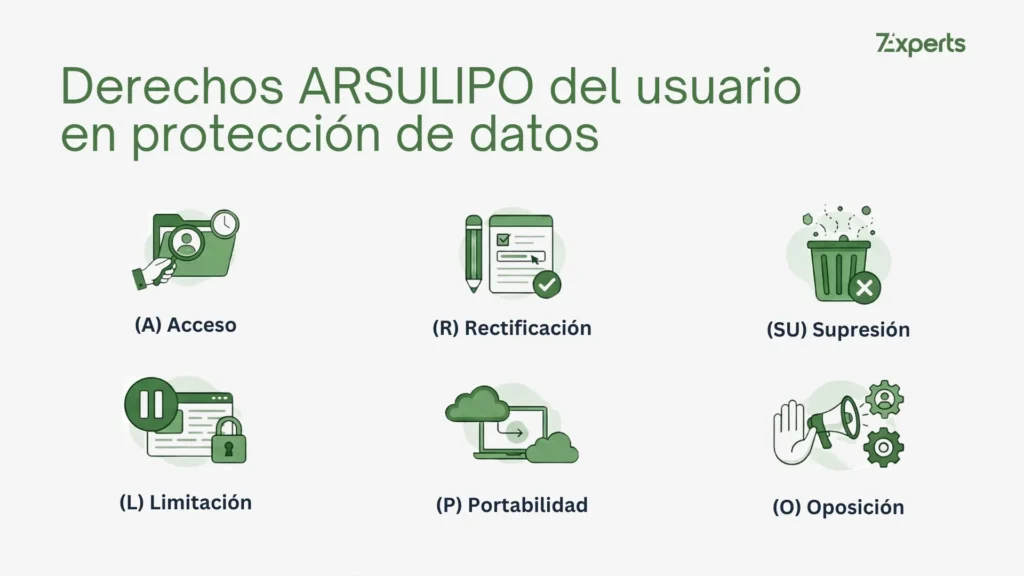
Fuente: 7experts
Independientemente de los derechos que ejercite el usuario, nunca se deben almacenar contraseñas en texto plano dentro de una base de datos. Almacenarlas sin cifrar constituye una infracción muy grave del principio de confidencialidad e integridad de la LOPDGDD. Las contraseñas deben guardarse siempre procesadas mediante algoritmos de hashing seguro (como bcrypt).